MI esettanulmány – Big data BI környezet és adatbetöltések készítése
Tartalomjegyzék
- Célkitűzések
- Elvárások
- Megfelelő verziók kiválasztása és docker környezet konfigurálása
- PySpark betöltések elkészítése
- Airflow DAG-ok elkészítése
- Prediktáló modellek kezelése
Célkitűzések
A cél egy autonóm befektetésmonitorozó és prediktáló környezet kialakítása, amely reziliens és jól skálázható. A rendszer továbbá neurális hálózat segítségével predikciókat végez, majd meghatározza a következő napi értékeket. Az eredmények ezt követően egy külön riportban jelennek meg.
Elvárások
A feldat megvalósítása során az egyes technológiák adottak:
- Apache Spark végrehajtó motor
- Apache Airflow ütemező
- MSSQL Server adattárház
- Docker hálózat
- Power BI riportálás
A megvalósítás során az AI segítéségét a következő részekben vettem igénybe.
- Megfelelő verziók kiválasztása és docker környezet konfigurálása
- PySpark betöltések elkészítése
- Airflow DAG-ok elkészítése
- Prediktáló modellek kezelése (kiválasztása, tanítása, lecserélése)
A feladat megvalósítása során többnyire a ChatGPT ingyenes verzióját használtam.
Megfelelő verziók kiválasztása és Docker környezet konfigurálása
A cél egy könnyen telepíthető autonóm környezet kialakítása, amelyhez kézenfekvő megoldást nyújt a Docker. Ebben definiálni kell az egyes alrendszereket, a kommunikációhoz használt hálózatot, valamint a külső környezet felé biztosított interfészeket.
A felépített Big Data környezet gerincét a Spark végrehajtómotor adja. Ez JVM-en fut, és Spark job-ok futtatására alkalmas, amelyek legegyszerűbben PySpark segítségével definiálhatók. Ez magában foglalja egy Python- és Java-környezet konfigurálását is, amely kissé körülményes feladat.
Az ütemezéshez az Airflow-t választottam, amely szintén Python alapú rendszer.
Végül az MSSQL Server verziójának kiválasztása is szükséges volt, mivel ez szolgál adattárházként. Ennek konfigurálása általában nem okoz további jelentős problémákat.
Az LLM-től a következő prompt segítségével igyekeztem a kezdetleges környezetet kialakítani:
szeretnék docker compose segítségével egy big data környezetet felállítani, a következők alapján:
- Apache Spark végrehajtó motor
- Apache Airflow ütemező
- MSSQL server adattárház
A prompt ugyan kissé szűkszavú, ennek oka az volt, hogy a részletek (verziók és implementációs megoldások) kiválasztásában szabad kezet kívántam adni a modellnek. Azt feltételeztem, hogy bár összetett kérésről van szó, ha egyetlen kontextuson belül bírom rá a feladat teljes megoldására, akkor konzisztens eredményt tud szolgáltatni.
A válasz lényegesebb részei egy docker-compose.yaml, Docker fájlok, egy tesztbetöltés, valamint a javasolt mappastruktúra voltak:
bigdata-platform/
│
├── docker-compose.yml
├── .env
│
├── airflow/
│   ├── Dockerfile
│   ├── requirements.txt
│   └── dags/
│       └── sample_etl.py
│
├── spark/
│   ├── Dockerfile
│   ├── apps/
│   │    └── sample_job.py
│   └── jars/
│        └── mssql-jdbc-12.8.1.jre11.jar
│
├── sqlserver/
│   └── init/
│
└── data/
...
version: "3.9"

services:

  ####################################################
  # SQL SERVER
  ####################################################
  sqlserver:
    image: mcr.microsoft.com/mssql/server:2022-latest
    container_name: sqlserver
    hostname: sqlserver
    environment:
      ACCEPT_EULA: "Y"
      MSSQL_PID: Developer
      SA_PASSWORD: Password123!
    ports:
      - "1433:1433"
    volumes:
      - sql_data:/var/opt/mssql
    networks:
      - bigdata

  ####################################################
  # POSTGRES (Airflow metadata)
  ####################################################
  postgres:
    image: postgres:16
    container_name: postgres
    environment:
      POSTGRES_USER: airflow
      POSTGRES_PASSWORD: airflow
      POSTGRES_DB: airflow
    volumes:
      - postgres_data:/var/lib/postgresql/data
    networks:
      - bigdata

  ####################################################
  # SPARK MASTER
  ####################################################
  spark-master:
    build:
      context: ./spark
    container_name: spark-master
    hostname: spark-master
    environment:
      SPARK_MODE: master
    ports:
      - "7077:7077"
      - "8080:8080"
    volumes:
      - ./spark/apps:/opt/spark/apps
      - ./spark/jars:/opt/spark/jars
      - ./data:/data
    networks:
      - bigdata

  ####################################################
  # SPARK WORKER
  ####################################################
  spark-worker:
    build:
      context: ./spark
    container_name: spark-worker
    depends_on:
      - spark-master
    environment:
      SPARK_MODE: worker
      SPARK_MASTER_URL: spark://spark-master:7077
    volumes:
      - ./spark/apps:/opt/spark/apps
      - ./spark/jars:/opt/spark/jars
      - ./data:/data
    networks:
      - bigdata

  ####################################################
  # AIRFLOW INIT
  ####################################################
  airflow-init:
    build:
      context: ./airflow
    depends_on:
      - postgres
    environment:
      AIRFLOW__CORE__EXECUTOR: LocalExecutor
      AIRFLOW__DATABASE__SQL_ALCHEMY_CONN: postgresql+psycopg2://airflow:airflow@postgres/airflow
    command: >
      bash -c "
      airflow db migrate &&
      airflow users create
      --username admin
      --firstname Admin
      --lastname User
      --role Admin
      --email admin@test.hu
      --password admin
      "
    networks:
      - bigdata

  ####################################################
  # AIRFLOW WEBSERVER
  ####################################################
  airflow-webserver:
    build:
      context: ./airflow
    container_name: airflow-webserver
    restart: always
    depends_on:
      - airflow-init
    environment:
      AIRFLOW__CORE__EXECUTOR: LocalExecutor
      AIRFLOW__DATABASE__SQL_ALCHEMY_CONN: postgresql+psycopg2://airflow:airflow@postgres/airflow
    command: webserver
    ports:
      - "8081:8080"
    volumes:
      - ./airflow/dags:/opt/airflow/dags
    networks:
      - bigdata

  ####################################################
  # AIRFLOW SCHEDULER
  ####################################################
  airflow-scheduler:
    build:
      context: ./airflow
    depends_on:
      - airflow-init
    environment:
      AIRFLOW__CORE__EXECUTOR: LocalExecutor
      AIRFLOW__DATABASE__SQL_ALCHEMY_CONN: postgresql+psycopg2://airflow:airflow@postgres/airflow
    command: scheduler
    volumes:
      - ./airflow/dags:/opt/airflow/dags
    networks:
      - bigdata

networks:
  bigdata:

volumes:
  sql_data:
  postgres_data:

....

Spark docker file:

FROM bitnami/spark:3.5

USER root

RUN install_packages python3-pip

COPY jars /opt/spark/jars

WORKDIR /opt/spark/apps

USER 1001

...

airflow docker file:

FROM apache/airflow:2.10.0-python3.11

USER root

RUN apt-get update && \
    apt-get install -y procps curl && \
    apt-get clean

USER airflow

COPY requirements.txt .

RUN pip install --no-cache-dir -r requirements.txt
Eredmények
Sajnos a generált környezet nem működött azonnal.
Rengeteg probléma merült fel, mire az AI által generált tesztbetöltés megfelelően lefutott. Minden egyes esetben kikértem a modell véleményét, valamint manuálisan is megvizsgáltam a hibákat. Amennyiben a javasolt megoldás jelentősen eltért a probléma valódi okától (például egy, a hibától független modulban próbált módosításokat végrehajtani), új promptot kezdtem, és igyekeztem a modellt a helyesnek vélt irányba terelni.
A felmerülő problémák:
- Nem támogatott spark disztribúció a compose-ban
- Hibás volume definíció mssql esetén (a hibaüzenet ellenére az airflow-n akart változtatni az LLM, többedik prompt után az első StackOverflow postban volt a megoldás)
- Airflow esetén hiányos
requirements.txtésDockerfilefájlok miatt nem indult el - Hiányos
docker-composeésDockerfilespark esetén, így sem a worker sem a master nem tudott elindulni (a megoldásaival további nyilvánvaló hibákat vezetett be magának) - Töltéshez fel kellett konfigurálni az Airflow conneciton-jeit
- Spark és Airflow-t nem rakta azonos volume-ba így nem láttak rá közösen a töltésre
- Spark és Airflow alapból más Python verziókat használ
- A Spark más verzióban volt az Airflow esetén beimportálva, mint a worker, illetve master-ben
- Az adatbázis driver-ek nem voltak megfelelően az egyes konténerekbe másolva, illetve azokat nem használta az Airflow
- A Spark worker és master más Python verziókkal jöttek létre
Összességében ezt a feladatot az AI használata csak nehezítette. A felül felsorolt problémáknál egyenként alsóhangon egy legalább 2-3 iterációból álló beszélegtés kellett csupán arra, hogy a hiba okát megértse. Annak ellenére, hogy a kezdő prompt-ban szerepeltek a Docker, illetve compose és további konfigurációs állományok. Ebből kifolyólag lassan és gyengén tudott előrelépéseket javasolni és a javasolt megoldás gyakran még így is kevésnek bizonyult. A kezdetei konfiguráció bár első megközelítésre hasznosnak tűnhetett, a véget nem érő javítási terációk a kiinduló állapotot teljes mértékben megváltoztatták.
Az LLM minden egyes komponens esetén képes volt további hibákat tartalmazó konfigurációs állományokat generálni.
A debug-olás során érdekes volt, hogy az LLM gyakran egy orvos módjára tünetek alapján próbálta diagnosztizálni hibákat. Gyakran önmagából a hibaüzenetből nem tudta kikövetkeztetni a megoldást, így megkért, hogy debug-olásra szolgáló ellenőrző bash parancsokat futtassak.
Worker konténerben:

docker exec -it spark-worker bash

majd:

spark-submit --version

Ennek ezt kell mutatnia:

version 3.5.2

Python oldalon:

python3 -c "import pyspark; print(pyspark.__version__)"

eredmény:

3.5.2

Airflow konténerben:

python -c "import pyspark; print(pyspark.__version__)"

szintén:

3.5.2
Ez lényegében pont egyenértékű azzal, mint, amihhez hasonlót én is kezdtem volna mint laikus, azonban az AI-ra úgy tekintettem, mint amely nálam jártasabb ezen a területen, így a hibaüzenetek alapján képes diagnosztizálni és megfelelő kódot generálni. A végeláthatatlannak tűnő iterációkat követve, pusztán az hibaüzenetre rákeresve gyakran megoldásokat találtam StackOverflow, amely tovább erősíti az AI-val szemben a kételyt.
Érdekes tapasztalat volt továbbá, hogy egy-egy javasolt megoldás gyakran újabb hibákat idézett elő. Ezek egy részét még a beillesztés előtt sikerült kiszűrnöm és javítanom, azonban ez még inkább azt erősítette meg bennem, hogy a modellek válaszait nem szabad ellenőrzés nélkül elfogadni.
A modell elsősorban a rövid távú probléma megoldására törekszik: egy adott hibát igyekszik kijavítani, még akkor is, ha ennek következtében további problémákat vezet be a rendszerbe.
PySpark betöltések elkészítése
Egy python script-el szeretném a következő API végpontról adatbázisba tölteni különböző nemesfémek árait:
https://pm-prices.azurewebsites.net/api/pmprice/historical?metalId={metalId}&lang=en&startDate={"2026-01-01"}&endDate={"2026-01-31"},
ahol a dátum mindig az aktuális előtti hónap kezdete és vége, a metalId pedig:
- arany esetén 1
- ezüst esetén 2
- platina esetén 3

A script PySpark-ban legyen írva, és df.write() paranccsal mentsen.

Itt egy példa-betöltési kód:

from pyspark.sql import SparkSession

spark = (
    SparkSession.builder
    .appName("Sample ETL")
    .getOrCreate()
)

df = spark.read.csv(
    "/data/input.csv",
...

Az API válasz első pár sora:

{"meta":{"timestampResponse":"2026-07-12T19:44:53.28746Z","summary":[{"name":"lowest","bid":111.04,"offerUnfabricated":119.67,"offerFabricated":125.34},{"name":"highest","bid":121.72,"offerUnfabricated":131.17,"offerFabricated":137.38},{"name":"average","bid":115.88,"offerUnfabricated":124.87,"offerFabricated":130.79}],"unit":"g"},"rows":[[{"date":"2026-06-01","bid":{"value":122.35},"offerUnfabricated":{"value":131.85},"offerFabricated":{"value":138.09},"index":0,"validTo":"09:45 CET","unit":"g"},{"date":"2026-06-01","bid":{"value":121.75},"offerUnfabricated":{"value":131.2},"offerFabricated":{"value":137.41},"index":1,"validTo":"15:25 CET","unit":"g"},{"date":"2026-06-01","bid":{"value":120.91},"offerUnfabricated":{"value":130.3},"offerFabricated":{"value":136.47},"index":2,"validTo":"16:45 CET","unit":"g"}],[{"date"
A promptot követve a modell egy majdnem tökéletes megoldást generált, amelyben csupán adattípus-eltérésből származó hibák jelentkeztek. Ezeket a hibaüzenetek alapján gyorsan és helyesen javította.
A fentihez hasonló módon generáltam a kriptovaluta- és részvényadatok betöltéseit is. Az ezekhez tartozó promptok a következők voltak:
Egy python script-el szeretném a következő API végpontról adatbázisba tölteni különböző kriptovaluták árfolyamait:
https://api.coinmarketcap.com/data-api/v3.1/cryptocurrency/historical?id={id}&convertId=2781&timeStart={startTimeStamp}&timeEnd={endTimeStamp}&interval=1d,

ahol a dátum mindig az aktuális előtti hónap kezdete és vége, az id pedig:
- BTC esetén 1
- DODGE esetén 74
- ETH esetén 1027

A script PySpark-ban legyen írva és df.write() paranccsal mentsen.

Itt egy példa-betöltési kód:

from pyspark.sql import SparkSession

spark = (
    SparkSession.builder
    .appName("Sample ETL")
    .getOrCreate()
)

df = spark.read.csv(
    "/data/input.csv",
...

Az API válasz első pár sora:
{"data":{"id":1,"name":"Bitcoin","symbol":"BTC","timeEnd":"1735257599","quotes":[{"timeOpen":"2024-12-27T00:00:00.000Z","timeClose":"2024-12-27T23:59:59.999Z","timeHigh":"2024-12-27T09:07:00.000Z","timeLow":"2024-12-27T17:25:00.000Z","quote":{"name":"2781","open":95704.9745862557,"high":97294.8464204259,"low":93310.7438042296,"close":94164.8603483526,"volume":52419934565.0800000000,"marketCap":1864541907464.4600000000,"circulatingSupply":19802078,"timestamp":"2024-12-27T23:59:59.999Z"}}
Egy python script-el szeretném a következő API végpontról adatbázisba tölteni különböző részvények árfolyamait:

https://stockanalysis.com/api/symbol/{symbol}/history?range=10Y&period=Daily,
ahol a symbol a következő értékeket veheti fel:
- Microsoft esetén s/MSFT
- Apple esetén s/AAPL
- Amazon esetén s/AMZN

A script PySpark-ban legyen írva és df.write() paranccsal mentsen.

Itt egy példa-betöltési kód:

from pyspark.sql import SparkSession

spark = (
    SparkSession.builder
    .appName("Sample ETL")
    .getOrCreate()
)

df = spark.read.csv(
    "/data/input.csv",
...

Az API válasz oszlopainak magyarázata:

- a = AdjClose
- ch = Change
- h = High
- l = Low
- t = date
- v = Volume

Az első pár sora pedig:

{"status":200,"data":[{"t":"2026-07-10","o":387.8,"h":391.91,"l":381.5,"c":385.1,"a":385.1,"v":23974029,"ch":0.19}
Eredmények
Összességében mindegyik esetben elmondható, hogy a prompt alapján tökéletes logikát generált a modell. Mindegyik esetben elvétett azonban konverziós hibákat, amelyeket gyorsan és hatékonyan javított.
Az egyszerűbb Python scriptek elkészítésére a modell kiváló segítséget tudott nyújtani, és jelentősen csökkentette a szükséges fejlesztési időt. Fontos azonban megjegyezni, hogy ezek a feladatok jóval pontosabban voltak definiálva, valamint a megvalósítás komplexitása is lényegesen alacsonyabb volt, mint a korábbi rendszerkonfigurációs feladat esetén.
Ennek ellenére a hatékonyságbeli különbség jelentős volt: míg a komplex környezet kialakításánál az AI gyakran hátráltatta a folyamatot, addig jól definiált, lokális problémák esetén kifejezetten hatékony segítséget nyújtott.
Airflow DAG-ok elkészítése
Ebben a lépésben a meglévő betöltéseket szeretném ütemezni. Az Apache Airflow DAG (irányított körmentes gráf) formájában ad lehetősget műveletek ütemezésére, ahol egy végrehajtandó feladat a gráf egy pontja, az irányított él pedig a függés irányát jelzi. A feladat meglehetősen egyszerű, így elöljáróban arra számítottam, hogy nem okoz különesebb nehézséget a modellnek.
Prompt:
Van három Python script-em Pyspark-ban írva. Ezeket szeretném Airflow-val ütemezni. Az ariflow készen áll, egyedül a DAG-ok megírása hiányzik.
A 3 script ne függjön egymástól.

Itt egy példa DAG:

from datetime import datetime
from airflow import DAG
from airflow.providers.apache.spark.operators.spark_submit import SparkSubmitOperator

with DAG(
    dag_id="sample_etl",
    start_date=datetime(2025, 1, 1),
...

A három ütemezni kívánt job a következő fájlokban van definiálva:
- /opt/spark/apps/cryptojob.py
- /opt/spark/apps/metaljob.py
- /opt/spark/apps/stockjob.py

Az ütemezés legyen minden reggel 6 órára allítva.
A válaszolt DAG:
from datetime import datetime

from airflow import DAG
from airflow.providers.apache.spark.operators.spark_submit import SparkSubmitOperator

with DAG(
    dag_id="daily_spark_etl",
    start_date=datetime(2025, 1, 1),
    schedule="0 6 * * *",   # minden nap 06:00
    catchup=False,
    tags=["spark", "etl"],
) as dag:

    crypto_job = SparkSubmitOperator(
        task_id="crypto_job",
        application="/opt/spark/apps/cryptojob.py",
        conn_id="spark_default",
        jars="/opt/spark/jars/mssql-jdbc-13.4.0.jre11.jar",
    )

    metal_job = SparkSubmitOperator(
        task_id="metal_job",
        application="/opt/spark/apps/metaljob.py",
        conn_id="spark_default",
        jars="/opt/spark/jars/mssql-jdbc-13.4.0.jre11.jar",
    )

    stock_job = SparkSubmitOperator(
        task_id="stock_job",
        application="/opt/spark/apps/stockjob.py",
        conn_id="spark_default",
        jars="/opt/spark/jars/mssql-jdbc-13.4.0.jre11.jar",
    )

    crypto_job
    metal_job
    stock_job
Eredmények
A DAG elsőre helyesn lefutott.
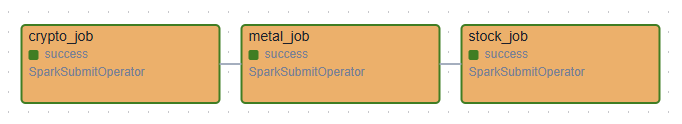 Az eredmény nem lepett meg, mivel a feladat meglehetősen egyszerű volt. Alapvetően az Airflow konfgurálás unalmas tud lenni és repetitív jellege miatt könnyen elrontható. Ilyen feladatra, ahogy az megbizonyosodott egy kellően pontosan definiált prompt alapján, rengeteg időt tudunk spórolni DAG-ok generálásával.
Prediktáló modellek kezelése (kiválasztása, tanítása, lecserélése)
Az utolsó feladatrész a korábbi kettőhöz képest lényegesen összetettebb volt. Ebben az esetben nem csupán egy mélytanuló modell elkészítése volt a cél, hanem a modell karbantartásához szükséges logika implementálása, valamint a meglévő architektúrába történő integráció is a megfelelő konfigurációs állományok módosításával.
A modellt előzetesen én választottam ki (LSTM, amely idősoros adatok prediktálására előnyös), azonban az implementáció részleteiben teljes szabadságot kapott az LLM.
Bemeneti prompt:
Van egy meglévő docker-compose hálózatom egy airflow ütemezővel, spark végrehajtó-motorral.
Az adatbázisban a következő táblákban és oszlopokkal érhető el adat:
- master.dbo.CryptoPrices date, open_price, symbol
- master.dbo.PM_Prices date, bid, metal_id
- master.dbo.StockHistory TradeDate, OpenPrice, Symbol

A megadott szimbólumokra szeretnék minden nap egy predikciót végezni a következő napra az elmúlt 30 nap adata alapján.

Minden szimbólumhoz külön modell prediktál. A modelleknek az összes korábbi adaton kell betanulniuk.

A modellek tanítása hetente egyszer történjen. A folyamat során össze kell hasonlítani a meglévő modellt az újonnan betanított modellel, és amennyiben az új modell eredményesebb, akkor le kell cserélni a napi predikciókhoz használt modellt az adott szimbólum esetén.

A prediktálás és tanítás Spark job-ok formájában legyen megvalósítva, amelyeket Airflow ütemez.

A modellek LSTM architektúrát használjanak.

A jelenlegi compose állomány:
...

Airflow Dockerfile:
...

Spark Dockerfile:
...

Egy példa job:
...

Egy példa DAG:
...
Nem vártam az AI-tól konkrét megoldást, tudtam, hogy ez pár fájl módosításánal komplexebb, illetve megigényli a kész komponensek elemzését, így kíváncsi voltam, hogy milyen válasszal áll elő. A válasz egy terv volt, hogy miket, hogyan kell módosítani, azonban csupán nagy vonalakban, főleg ábrákkal:
Airflow
Napi DAG
00:05

↓

Prediction Spark Job

↓

SQL Write
Megkértem ezt követően, hogy adja vissza a konkrét módosításokat és generálja le az új szükséges fájlokat, azonban ehelyett azt javasolta, hogy haladjunk lépésről lépésre. Kíváncsiság képpen kipróbáltam a Claude-al is, amely 30 perc gondolkodás után adott hasonló választ.
Az AI bár képes lenne gyakran megoldani a problémát, ha az rengeteg generálással, kimenettel járna, akkor hajlamos megállni és feltartani a választ egy alapvetőnek tűnő kérdéssel, esetleg kéréssel. Például, akárhogy kérjük meg, nem hajlandó elszámolni 1-től 1000-ig, hiába képes rá. Akárhogyan is próbálkozunk nem lehet rávenni, hogy egyben számoljon el.
Eredmények
A megoldás megvalósítása során több hibával is szembesültem. Amennyiben a hiba javítása nem igényelte a kezdeti kontextus teljes ismeretét, új beszélgetést kezdtem. Ezzel csökkentettem a korábbi, kevésbé releváns információk által elfoglalt kontextusméretet, és pontosabb válaszokat próbáltam elérni.
A folyamat során felmerült hibák:
- Inkompatibilis TensorFlow-verzió szerepelt a Dockerfile-ban.
- Hiányoztak bizonyos szükséges könyvtárak telepítései.
- Olyan fájlokra vagy konfigurációkra hivatkozott a modell, amelyek korábban nem kerültek létrehozásra.
A konfigurációt illető problémák a fentiekhez hasonlóan itt is kifejezetten nehézkesen oldódtak meg. Valamiért ez egy gyenge pontja az LLM-eknek és képtelen a helyes verziók és könyvtárak kombinációjának kitalálására.
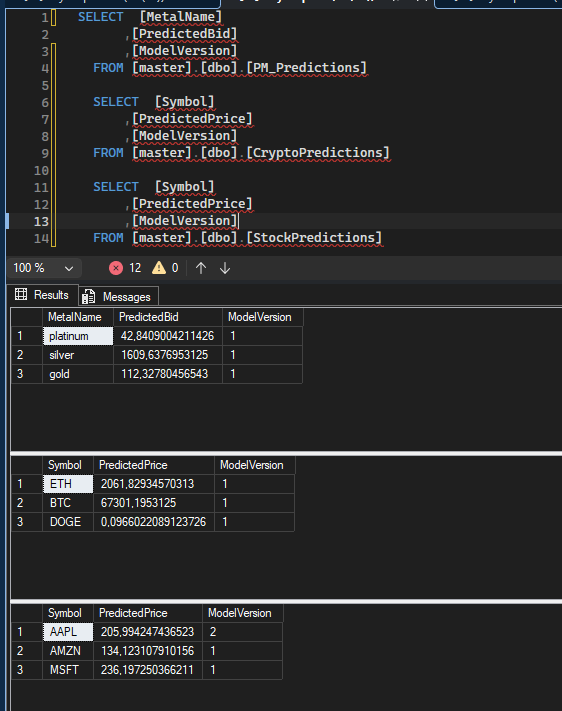
Meglepő volt azonban, hogy a kezdeti konfigurációs nehézségeket követően, az egyes segédfájlok, tanítások, predikciók mind Spark job-jai, mind Airflow DAG-jai, közel egyből jól lettek legenerálva. Megesett, hogy olyan fájlra hivatkozott, amit nem generált le korábban, azonban jelezve ezt pontosan és helyesen tudta javítani hibáját.
Az eredmények:
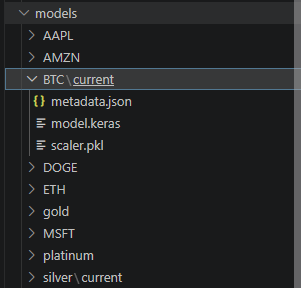
A modelleket, pedig a következő formátumban egy volume-on keresztül mentette le:
Tanulságok
A fejlesztés során az alábbi tanulságok vonhatóak le:
- Az LLM-ek komplex rendszer tervezésére alkalmas és hatékony, de csak adott logikai szinten belül maradva. Az a kontextus, amely a magas szintű tervre ad választ, az implementációban pontatlan lesz, ellentétben vele, az a modell, amely csak adott problémát old meg, nem látja át a rendszert és képtelen hosszú távon hatékony megoldással szolgálni.
- Konfigurációs állományok előállítására alkalmatlan. Rengeteg hibát vét a különböző verziók közötti inkompatibilitásból kifolyólag, továbbá a változtatásai gyakran már helyes konfigurációs állományokat rontanak el.
- Elég részletes prompt alapján, jól ledefiniált bemenetekkel és kimenetekkel hatékonyan tud hatékony és jól skálázódó Python kódot generálni. Rengeteg felesleges kódolási órát takaríthat itt meg, az adott függvények megfelelő és hatékony alkalmazásában, paraméterezésében kifejezetten ügyes. Ugyanakkor a felülvizsgálat elengedhetetlen, különben nehéz a kód további módosítása/javítása.
- A modern Big Data technológiákban (Spark, Airflow) jártas és nagy segítséget tud nyújtani, főleg paraméterezésekben.